Przenośny, natywny dla Gita model pamięci AI czytelnej dla agentów
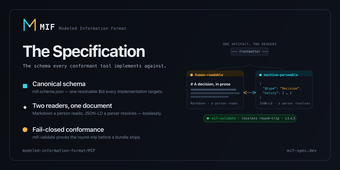
MIF (Modeled Information Format), z Modeled Information Format, zapewnia neutralny dla dostawców model danych do przenośnej wymiany wiedzy AI. Pakietuje edytowalny przez ludzi Markdown i przyswajalny przez maszyny JSON-LD, aby tworzyć lokalne, czytelne przez agenta pakiety wiedzy dla asystentów zintegrowanych z MCP i agentowych przepływów pracy. Kluczowe elementy obejmują kanoniczne źródło Markdown, pochodne projekcje JSON-LD, pochodzenie W3C PROV, bi-temporalną ważność i integrację serwera MCP. Inżynierowie AI i menedżerowie wiedzy używają go do utrzymywania pamięci AI native dla Git i redukcji nadmiaru tokenów.
Jakie zadania można rzeczywiście wykonać za pomocą MIF?
MIF koncentruje się na problemie trwałej pamięci AI, produkując kontekstowe pakiety, które mogą być używane przez agentów z dużą precyzją. Format definiuje typy semantyczne, epizodyczne i proceduralne oraz wspiera typowane relacje do mapowania złożonych bytów. Zespoły używają tych pakietów, aby ujawniać zorganizowany kontekst asystentom podczas rozwiązywania zapytań, aby utrzymać edytowalne przez ludzi źródło prawdy i aby reprezentować wiedzę w sposób, w jaki agenci mogą programowo zapytywać.
Jak dokładne i śledzone są projekcje czytelne maszynowo?
Uzyskane projekcje zawierają metadane zgodne z W3C PROV oraz bi-temporalne śledzenie, aby dokumentować pochodzenie i świeżość, co poprawia śledzenie dla przetwarzania downstream. Dokładność wyników skierowanych do agentów zależy od jakości kanonicznego Markdown, ponieważ ludzie tworzą źródło prawdy. W praktyce niezawodność wzrasta, gdy autorzy uwzględniają pola pochodzenia i wyraźne okna ważności podczas tworzenia, ponieważ format polega na tych sygnałach, aby zapobiec serwowaniu przestarzałego kontekstu.
Jakie wejścia i wzorce wdrożenia są wymagane?
Przepływ pracy jest natywny dla systemu plików i Gita, więc projekty przechowują pakiety wiedzy jako pliki tekstowe, a nie w zewnętrznych bazach danych wektorowych. MIF może działać jako serwer MCP (mif-mcp) i integruje się z klientami, którzy wspierają Model Context Protocol; wdrożenie pasuje do środowisk Node.js i TypeScript oraz powszechnych integracji edytorów, takich jak VS Code. Projekt usuwa obowiązkową warstwę bazy danych i pozwala zespołom na przechowywanie pamięci wewnątrz repozytorium projektu.
Czy MIF jest praktyczny w porównaniu z systemami pamięci opartymi na bazach danych?
MIF kładzie nacisk na neutralność dostawcy i przenośność ponad funkcje bazy danych, używając prostego Markdown jako kanonicznego artefaktu, co unika uzależnienia od własnościowych formatów przechowywania. Jego zgodność z OKF wspiera interoperacyjność z innymi narzędziami, które posługują się tym samym modelem transportowym. Projekty, które potrzebują szybkiego eksperymentowania z pamięcią lokalną i wyraźnym pochodzeniem, mogą je przyjąć bez wprowadzania zewnętrznego magazynu wektorowego, chociaż dostosowanie istniejących pipeline'ów może wymagać mapowania obecnych schematów do opiniotwórczego modelu treści MIF-a.
MIF pasuje do zespołów inżynieryjnych, które priorytetowo traktują przenośny, przeglądalny kontekst AI
MIF jest praktyczną opcją dla inżynierów AI i menedżerów wiedzy, którzy potrzebują przenośnej, lokalnej pamięci, którą agenci mogą odczytywać. Jego głównym ograniczeniem jest zależność od kuratowanych plików źródłowych dla poprawności wyników, więc zespoły powinny dodać kroki przeglądu i walidacji autora do swojego procesu tworzenia treści. Traktowane jako część szerszego przepływu weryfikacji, pasuje do projektów, które preferują pamięć natywną repozytoriów zamiast zewnętrznych usług baz danych.